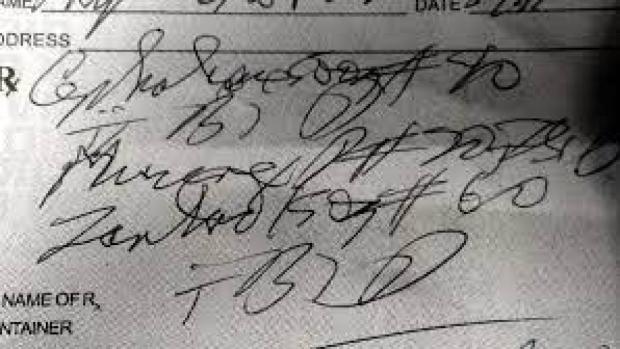
Міністерство економіки України разом із Державним архівом та іншими відомствами розпочало створення національного датасету україномовних рукописних матеріалів для навчання систем штучного інтелекту. Мета — навчити мовну модель розбирати старі рукописи, в тому числі — медичні довідки, передають Патріоти України.
Про деталі проєкту розповів ML Lead застосунку "Мрія" та радник зі штучного інтелекту в Мінекономіки Дмитро Войтех у подкасті AI&I.
Реалізація цієї ініціативи має пришвидшити цифровізацію державних послуг і сприяти оцифруванню архівних матеріалів.
Потреба у створенні такого датасету виникла під час роботи над проєктом "єДозвіл", який передбачає переведення процесу видачі ліцензій для підприємців у цифровий формат через "Дію". Для цього алгоритмам необхідно аналізувати документи, які подають заявники.
Зокрема, для отримання частини ліцензій потрібно завантажувати дипломи, видані ще у 1990-х роках, які часто заповнені від руки, мають низьку якість зображення або пошкодження. Як зазначив Войтех, наявні OCR-системи не забезпечують належного розпізнавання таких матеріалів українською мовою.
За словами розробників, у відкритому доступі відсутні якісні розмічені корпуси українського рукописного тексту, необхідні для навчання моделей. Тому Мінекономіки ініціювало співпрацю з іншими державними установами для швидкого формування відповідної бази.
Ключовим партнером став Державний архів України, який зацікавлений у використанні технології для оцифрування мільйонів сторінок історичних документів і спрощення доступу до інформації

Нове дослідження показало, що передня та задня частини мозку людини мають різне клітинне походження. На ранніх етапах розвитку вони формуються з двох окремих популяцій клітин-попередників, які не переходять одна в одну, передають Патріоти України. Про ...
Заміна звичайної кухонної солі на збагачену калієм альтернативу потенційно може щороку запобігати майже 3 мільйонам смертей і 10 мільйонам нових випадків серцево-судинних захворювань та хвороб нирок. Такого висновку дійшли дослідники Інституту глобальн...